데이터 모델링 순서 절차1. 업무 파악어떤 업무를 모델링할 것인지, 최종 결과물이 어떻게 나와야 하는지2. 개념적 데이터 모델링하고자 하는 일의 데이터 관계를 구상하는 단계3. 논리적 데이터 모델링개념적인 데이터 모델이 완성되면 만드는 구체화된 업무 중심의 데이터 모델key, 속성, 관계 등을 표시하고 정규화 수행(*정규화: 데이터 모델의 일관성을 확보하고 중복을 제거하여 신뢰성 있는 데이터 구조 생성)4. 물리적 데이터 모델링데이터를 관리할 실제 데이터베이스 선택 및 실제 테이블 생성(SQL 프로그래밍으로 구현하는 단계)논리적 데이터베이스물리적 데이터베이스엔티티(Entity)테이블(Table)속성(Attribute)컬럼(Column)주 식별자(Primary Identifier)기본키(Primary Ke..
home

운영체제(Operating System)컴퓨터 하드웨어를 관리하는 소프트웨어컴퓨터 시스템은 하드웨어, 운영체제, 응용 프로그램, 사용자로 구분할 수 있음일반적으로 하나 이상의 CPU와 버스(Bus, I/O 장치 컨트롤러, 디스크 컨트롤러, CPU 등이 메모리에 접근할 수 있도록 연결해 주는 선), 여러 장치 컨트롤러로 구성되어 있음운영체제에는 각 장치 컨트롤러마다 장치 드라이버가 있음*장치 드라이버: 장치 컨트롤러의 작동을 파악해 장치에 대한 일관된 인터페이스를 운영체제에 제공컴퓨터 시스템의 구성1. 인터럽트인터럽트: CPU가 특정 작업을 수행하는 도중에 급하게 다른 일을 처리하고자 할 때 사용하는 기능인터럽트 핸들러가 관리함인터럽트 받음 -> 수행하고 있던 위치를 저장 -> 인터럽트 실행 -> 인터럽트..
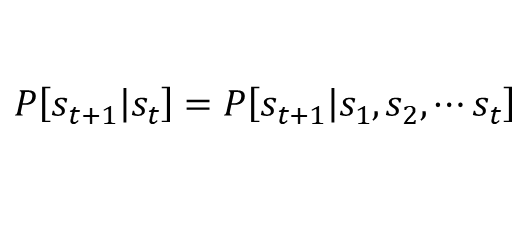
강화학습의 특징No supervisor - 딥러닝의 지도 학습처럼 정답 레이블이 없음agent가 선택한 답에 대한 Feedback이 즉각적이지 않음시간이 중요(순서!!)(non iid data - 같은 확률 분포를 가진 독립적인 데이터들)agent의 행동이 나중에 agent에게 영향을 줌강화학습 문제 공식state(상태) - action(행동) - reward(보상)S0, A0, R1, S1, A1, R2, ..., Sr-1, Ar-1, Rr, Sr강화학습의 목적: 누적 보상 최대화Marcov Decision Process마르코프 결정 과정: 미래는 현재에 의해서만 결정된다. 미래는 과거와 독립적이다.St+1에 영향을 주는 것은 St뿐임POMDP(Partially Observable Markov Deci..

Marcov Assumption마르코프 가정: 상태 St+1은 상태 St에 의해서만 결정된다.즉, 미래를 결정하는 것은 현재뿐이다. 과거는 상관없다.Marcov Process마르코프 가정을 만족하는 연속적인 일련의 확률 과정일련의 상태 와 상태 전이 확률 P로 이루어짐MP = (S, P)상태 전이 확률 P_ij = Pr(St+1 = sj | St = si): 상태 i에서 상태 j로 바뀔 확률*P_ij: P에 아래첨자 i, j+) Marcov Reward Process각 상태에서의 보상 측정마르코프 과정, 보상 R, 감가율 γ(감마)로 이루어짐MRP = (S, P, R, γ)상태 집합 S = {s1, s2, ..., s}: MDP에서 가질 수 있는 모든 상태의 집합상태 전이 확률 P_ij = Pr(St+1..
A -> 1, B -> 2, C -> 3, ..., Z -> 26, AA -> 27, AB -> 28,...과 같은 원리로 문자를 바꿔야 한다. 딱 보기에도 규칙이 보이지만 코드로 써 보려니 어려웠다. 뼈대 코드 #include #include int col_to_num(char col[]) { int len = strlen(col); long long num = 0; int i=0; while (i
